ai美女提示词怎么写?避免千篇一律的写法
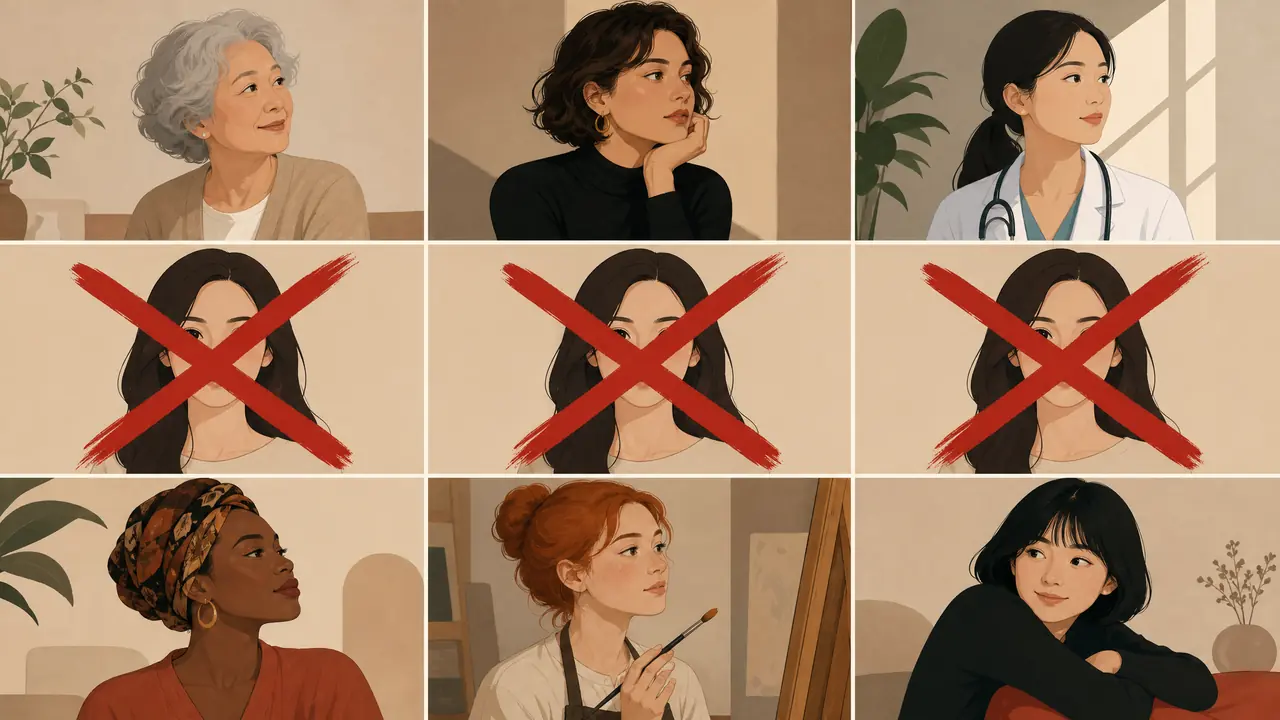
开门见山:ai美女提示词想不撞脸,别把钱花在颜值形容词上,把预算给气质词、职业场景和年龄跨度。颜值词决定的是「好看」,这三样决定的是「是谁」。下面有一组固定参数的对照数据,照着换词就能看到差别。
ai美女提示词最容易出的毛病,不是出不了好看的图,是出一堆好看但互相撞脸的图。2026年2月我帮朋友的长篇小说选封面人物,跑了一批「美女、大眼睛、白皮肤、精致五官」,五十多张图摆在一起,第一眼像同一个模特换了衣服。
挺离谱的。挑了三个晚上,敢用的只有三张,还全是瓜子脸加平行双眼皮。问题不在模型,在写法:全是大而空的颜值词,模型只能往它见得最多的那种「标准美人」上靠。这篇把当时的记录和后来补做的对照实验整理出来,给一套能直接抄的替代写法。
先看撞脸:同一批词能出六成以上的相似脸
全是抽象颜值词的ai美女提示词,25张里能出17张相似脸,重合率约68%。换个说法:你写得越「标准」,模型越没有自由度,它只能取平均。
当时我把那批废图按脸型归了个类:50张里31张是瓜子脸,19张用了几乎一样的平行双眼皮加高鼻梁组合,发际线到眉骨的比例也高度接近。不夸张地说,把其中十张的脸裁下来打乱,我自己都分不出哪张是哪条指令出的。
后来换个思路验证:同一模型、同一组参数(固定种子、采样步数30),只改提示词,看脸的重合率会不会动。2026年3月跑了三轮对照,每轮25张,结果如下。
| 组别 | 提示词写法 | 25张里的相似脸 | 我的主观评价 |
|---|---|---|---|
| A组 | 美女、大眼睛、白皮肤、精致五官、完美比例 | 17张,约68% | 好看但没用,选封面像抽签 |
| B组 | 颜值词换成气质词:知性、英气、松弛感,各配一句行为描写 | 6张,约24% | 开始有「人味」,场景感还缺 |
| C组 | 气质词加职业加年龄:19岁体校生、42岁法医、58岁茶馆老板娘三档 | 2张,约8% | 一眼分清谁是谁,出片最稳 |
数字摆在这儿,不用多解释。气质词管神态,职业场景管环境、服装、动作和光线,年龄管皮肤质感和骨相。三层叠上去,模型被迫在一张具体的脸上做决定,而不是在「标准美」里取平均。
分寸:审美多样不等于换着贴标签
气质词是拉开差距的抓手,单独写出来照样空,必须落到具体的行为和物件上才起作用。「知性」两个字不出图,扶着镊子翻残卷才出图。
这点我踩过坑。B组第一版指令里我只写了「知性的气质」,出来的图还是红唇大波浪,只是背景换成了书房。后来学乖了:知性要写成「低头用镊子挑开残卷、睫毛垂着」,松弛感要写成「坐在门槛上剥橘子、肩膀是塌下来的」。指令里每个形容词,都得找到一个动作或物件替它作证。
另一层分寸是别把气质词当人贴标签。写「英气」不代表非要剑眉星目加一身戎装,一个蹲在菜市场讲价讲得干脆的大姐也可以英气;写58岁也不必默认慈祥,可以是掌柜式的精明里带一点疲惫。说实话,回避刻板印象的功夫全在细节里:多给职业里真实的倦意和烟火气,比堆十个形容词都管用。
话说回来,五官结构词本身也有优先级,脸型和眉眼的描述权重比「漂亮」高得多,这块想细抠的可以看这篇讲ai脸部提示词五官描述的优先级的文章,跟我说的气质词正好互补。
两条可以直接抄的ai美女提示词成稿指令
差异化ai美女提示词的骨架是年龄、职业场景、一个正在做的动作加光线,颜值形容词最多留一个。照这个槽位填,或者直接抄下面两条改细节。
第一条,写实向:「42岁的古籍修复师,短发微卷,素颜,深灰色亚麻围裙,午后工作台前用镊子挑开一页残卷,侧脸受窗光,85mm半身,写实人像」。第二条,生活向:「58岁茶馆老板娘,圆脸,眼角有笑纹,藏青色对襟褂子,老灶台边提铜壶倒水,手腕压低,热气糊住半个镜头,暖黄灯光,50mm纪实感」。我试了下,这两条在同一模型里各出10张,没出现两张需要犹豫二选一的情况。
换人设时,优先换职业和年龄段,气质词跟着动作重写,别只替换表面词。人物外貌、动作、神态三者的比重怎么分,这篇人物提示词外貌动作神态的配比讲得更细,可以配合着用。
年龄这一层的词差也有讲究。我对比过少年感和成熟感的写法,那套逻辑在ai男生提示词的年龄词差里拆得比较透,换个性别照样成立。
回到2026年2月那个挑封面的晚上。后来我用「古籍修复师」那条指令重跑了一次,十分钟就选到了能交稿的脸。ai美女提示词的差别不在词多,在于肯不肯把「漂亮」换成「是谁、在哪、正在干什么」。下次出图前先把这三件事想清楚,撞脸的问题基本就绕开了。
常见问题
写ai美女提示词,中文和英文差别大吗?
主流模型对两种语言都能处理,差别没有传说中那么大。真正影响结果的是描述的具体程度:中文写「眼角有笑纹的圆脸」照样出细节,英文堆 beautiful、gorgeous 也一样撞脸。习惯哪边就用哪边,关键是别用空词。
负面提示词能解决撞脸吗?
只能治标。负面词能去掉六指、多余肢体这类崩坏,但「长得像」是正向描述没给信息造成的,模型只好往平均值收。想拉开差距,正向词里的年龄、职业、动作才是主力。
同一个角色要出很多张图,怎么保持一致又不呆板?
把不动的部分锁死:脸型、发型、年龄写进固定句,每次原样保留。把动的部分交给场景和动作——同样的茶馆老板娘,这次倒水、下次擦柜台、再下次坐着打盹。一致性靠固定词,生动感靠变化词,两不耽误。
指令是不是越长越好?
不是。上面对照组的指令都没超过60字,堆到两三百字反而互相稀释。判断标准很简单:每个词都能指到一个看得见的东西就留,指不到的就删。