sd真人反向提示词怎么配?真人照片感的负面词清单
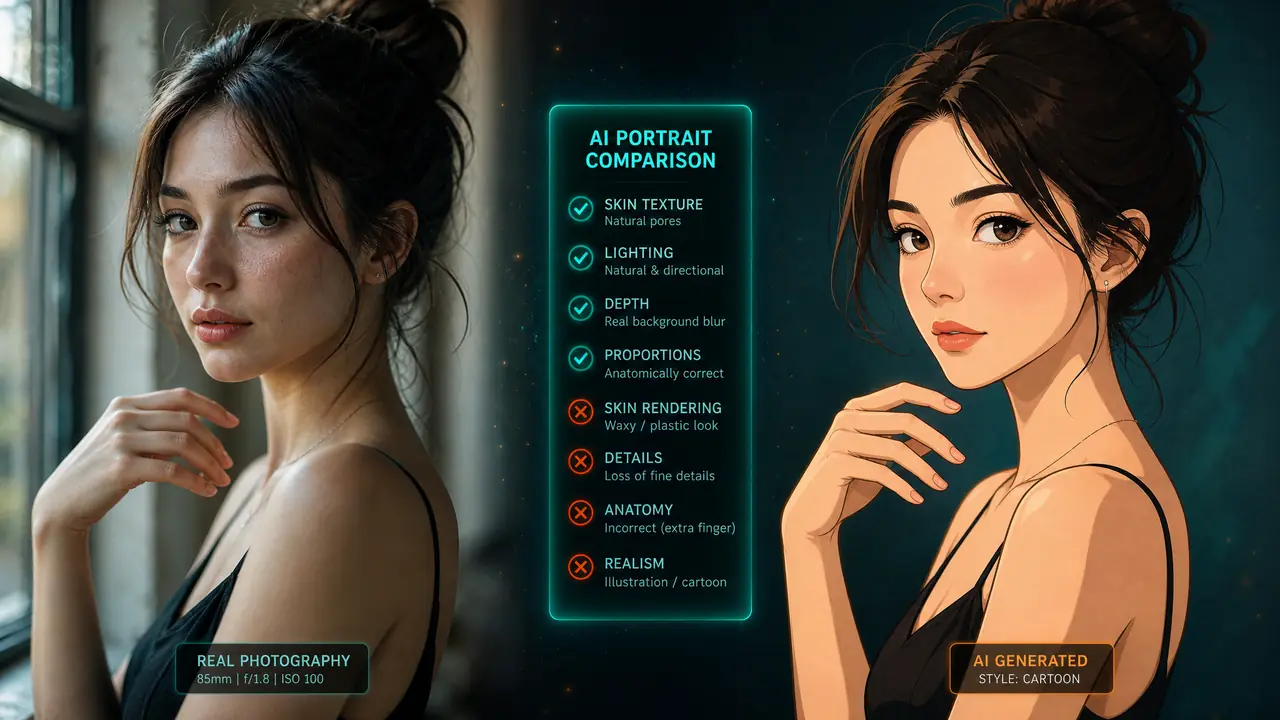
先把话放这儿:sd真人反向提示词不需要堆几十个词,真正决定真人照片感的是三条主力——画风尚词组、画质压制组、手部崩坏组。拿掉其中任何一条,盲选里立刻露馅;剩下的词都只是给这三条打下手,权重给错反而添乱。
sd真人反向提示词配对了,真人照片感能省一大半力气。我的判断很直接:负面词不用拉长清单,三条主力词扛走了八成效果,其余的都在打下手。这套结论不是拍脑袋来的,是我用固定seed一组一组加减试出来的。
过程比结论更有意思,下面摊开讲。
加减法测试是怎么做的
固定正面词、采样参数和seed,一次只增减一条负面词出图对比,两周跑了上百张,规律比想象中清楚。
设置先交代清楚。写实系底模加一个人像LoRA,采样器 DPM++ 2M Karras,30步,CFG 7,seed 固定在 886231055。正面词也锁死:35岁亚洲男性、窗边自然光、85mm 焦段。负面词池列了 14 条候选,从 cartoon 到 watermark 都在里面。每条词跑两轮,一轮带它,一轮不带,其它条件一个字不动,每轮出 4 张。两周断断续续,前后出了 112 张。
怕自己看走眼,我把 48 张关键对照图打乱编号导进相册,第二天让做设计的同事盲选哪边更像真实照片。结果比预想的狠:只要去掉那三条主力,12 组里有 9 组被一眼认出是 AI。说真话,那一刻有点被自己的清单打脸——原来大半页负面词里,真正干活的没几个。
补一句该说的:测试里的人脸全是模型虚构的,不对应任何真人。这套方法用来做原创人像没问题,拿去仿冒真人的头像、伪造名人照片就越线了,别碰。
对照结果:sd真人反向提示词的三条主力词
画风尚词组、画质压制组、手部崩坏组,这三条拿掉后真人感掉得最快,盲选里一眼就被认出来,其余词只补零头。
第一条是画风尚词组:cartoon、anime、illustration、3d render。它的作用是堵死模型往插画跑的路。写实底模本身够硬,但只要这里松一点,人物就开始往日系脸漂。压到 1.4 之后,出图的渲染感肉眼可见地退了,皮肤开始有油光和高光的过渡。
第二条是画质压制组:worst quality、low quality、normal quality、blurry。别看像废话,拿掉它之后糊脸和脏斑回得飞快,低步数出图时尤其明显。第三条是手部崩坏组:bad anatomy、deformed hands、extra fingers。拿掉它的一轮里,六根手指准时回来报到。挺离谱的,模型对手指的执念比我想的深。
| 负面词组 | 拿掉后的盲选表现 | 我的权重 | 我的判断 |
|---|---|---|---|
| cartoon / anime / illustration / 3d render | 12 组里 9 组被认出 AI 味 | 1.4 | 主力,必带 |
| worst quality / low quality / blurry | 糊脸和脏斑明显回潮 | 1.3 | 主力,必带 |
| bad anatomy / deformed hands / extra fingers | 六指图准时回归 | 1.2 | 主力,当稳定器用 |
| watermark / text / signature | 变化几乎看不出 | 1.0 | 备着不亏 |
| nsfw 类 | 跟照片感无关 | 1.0 | 按场景决定 |
三条主力合计贡献了八成效果,盲选掉队率里它们仨占大头。这个排序跟我之前聊负面词优先级时的思路是吻合的,怎么分层、先保哪条,可以看这篇:反向提示词怎么写才有效?负面词优先级。顺序对了,清单短也能打。
次级词的加分点和翻车点
皮肤蜡像感靠 airbrushed 和 plastic 压得住,权重一过 1.3 皮肤糙得像磨砂,次级词的权重宁低勿高。
先说蜡像感。光靠三条主力,脸有时还是像上过蜡。我试了下把 airbrushed、plastic skin 加进负面,1.2 权重时蜡像感褪掉,毛孔出来了;手贱拉到 1.5,皮肤糙得像砂纸,噪点满屏。老实讲,次级词比主力词娇气得多。
再说翻车。有回我想排除男性脸,把 man 写进负面,结果同一 seed 下人物姿势跟着变形,肩膀窄了一截。负面词是会带动画面语义的,不是想删什么就删什么。那之后我只在性别真的跑偏时才动这类词。
最后是配合。负面词做减法,正面词的相机参数做加法,85mm、f/1.8、自然光这些词把照片感往回拉,两边一起使劲才稳。焦段光圈到底差多少,我单独测过一轮,写在提示词里的相机参数怎么写?焦段光圈的出图感这篇里。
绕回开头那句话:sd真人反向提示词这件事,做减法比做加法重要。先把画风尚词组、画质组、手部组这三条主力配稳,再看皮肤和场景要不要补词。清单短一点,图反而真一点。有空你自己跑一轮加减对照,比我给你任何现成清单都靠谱。
常见问题
负面词权重一般给多少合适?
主力词 1.3 到 1.4,次级词 1.0 到 1.2 就够。超过 1.5 容易过校正,出现皮肤噪点、构图僵硬这类新毛病。我实测 1.2 到 1.4 是收益最高的区间,再往上基本是负收益。
负面词是不是写得越长越好?
不是。长清单会互相稀释权重,还占提示词的 token 位,模型对每条词的注意力都被摊薄。控制在十来条、按优先级分层,比抄三百词的网传清单好得多。
换了模型之后负面词要重调吗?
要。写实底模和二次元底模的负面词几乎是两套逻辑。换底模后我习惯把负面词清空,重新跑一遍加减对照,十分钟就能摸清新模型的脾气,比硬套旧清单快。
能用负面词挡住不生成某个真人吗?
可以把名字写进负面词做拦截,但它不是硬保证。更稳妥的做法是别拿真人照片当参考图,生成的人像也别用于冒充他人。这条线踩了就是麻烦事,跟技术无关。