唱歌视频提示词怎么写?给翻唱配场景的指令
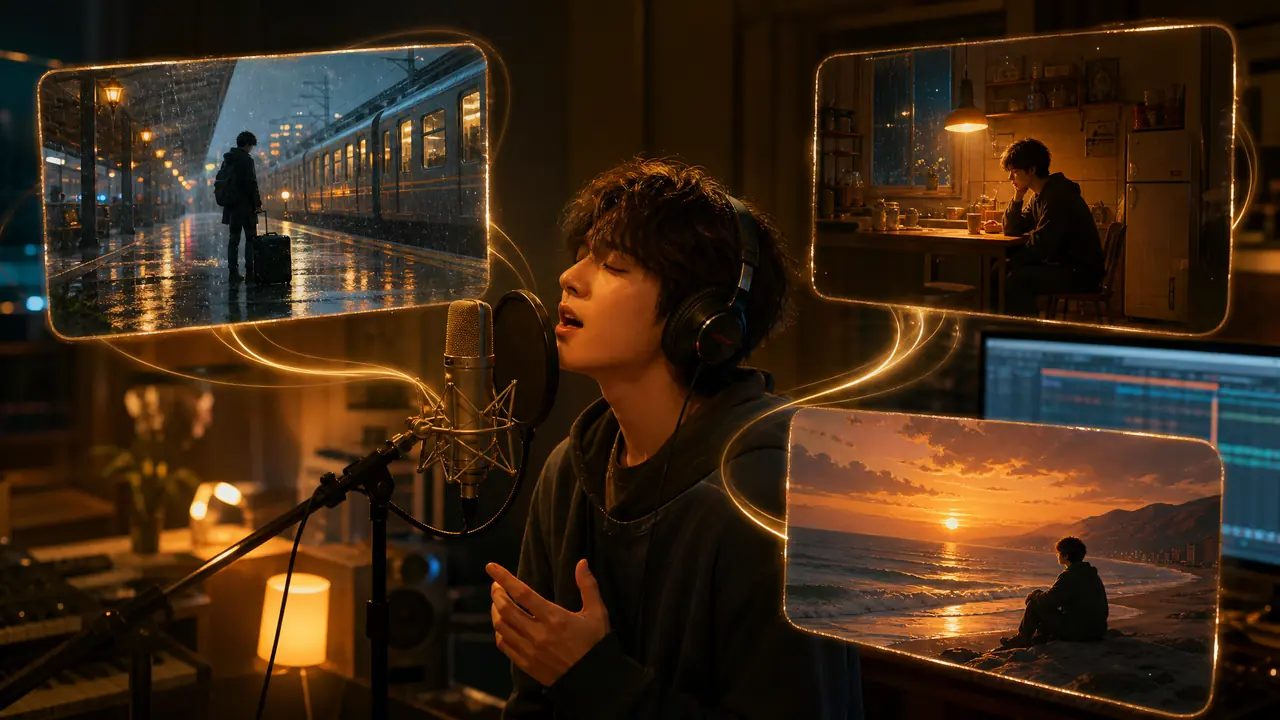
先给答案:唱歌视频提示词的写法是把翻唱按段落拆开,逐段给"场景加动作加镜头",比堆氛围词管用得多。我用同一首歌做了叙事、氛围、混合三版实测,叙事版完播率高出两成多,模板和踩坑点都在下面。
唱歌视频提示词写得好不好,差别不在词藻,在结构:先把整首歌拆成段落,再逐段告诉AI这段画面是什么、谁在动、镜头怎么走。我拿朋友的翻唱做过三版对照,叙事版完播率41%,氛围版只有33%,差距大到我现在写指令基本只走叙事思路。
唱歌视频提示词的三段式骨架
唱歌视频提示词分三段写:这段唱到哪、画面是什么、人在做什么加镜头怎么动。三样齐了AI才不乱编。
大部分人的写法是打开工具,敲一句"帮我生成一个唯美的唱歌视频",然后接受AI随机发牌。这样出来的东西基本没法用。
唯美是形容词,不是画面。
正经的拆法是按歌词结构走。主歌、预副歌、副歌、间奏,每段单独一条指令,一段管5到8秒的画面。指令里先交代位置,比如深夜厨房;再交代人物在干什么,比如背对镜头洗碗;最后补镜头和光线,从手部缓推到窗,暖黄台灯。三段信息各占一行,改起来也快。
间奏和尾奏最容易漏。我第一次做的时候间奏段空着没写,AI自己编了一段霓虹灯乱闪的舞台画面,跟整首歌的调子对不上。后来我固定给间奏补一条纯环境指令,比如"空厨房,窗外雨停,光线慢慢转暗",画面才接得上。慢歌尤其怕这种突兀的亮色。
我自己习惯再补一行"禁止项",比如"不要切换人物、不要出现文字"。AI视频工具很容易在片段结尾自作主张加个转场,写明禁止项能省掉不少重抽。老实讲,这一行救过我好几条素材。
三版画面实测:叙事版赢在哪
同一首翻唱、同一天发布,叙事版完播率41%,氛围版33%,混合版36%。前五秒有具体情节的画面,留人能力强过纯氛围堆砌。
事情是这样的。8月中旬,朋友把他翻唱的一首慢歌发我,让我帮忙配画面,条件是"三版都做,看哪版数据好"。我做了叙事版、氛围版、混合版各8个5秒片段。流程是先用文生图定首帧,再套让首图动起来的图生视频指令写法去生成动态,全流程下来24条指令,一条5秒片段出片大概90秒。
叙事版跟着歌词讲故事:主歌是深夜厨房,女生背对镜头洗碗,水声压过前奏;副歌切到清晨站台,她拖着行李箱回头。氛围版全是空镜,海面、晚霞、慢推慢拉,好看是真好看。混合版主歌给氛围,副歌给叙事。
数据出来那天我有点意外。完播率41%对33%,叙事版赢了两成多;点赞率倒差距不大,3.1%对2.8%。最扎心的是氛围版前五秒跳出率,将近三成观众没等唱进副歌就划走了。真不是氛围画面不好看,是它不给人"往下看会发生什么"的理由。
| 版本 | 画面内容 | 完播率 | 前五秒跳出 | 我的评价 |
|---|---|---|---|---|
| 叙事版 | 厨房、站台,跟着歌词走 | 41% | 12% | 略素,但留人 |
| 氛围版 | 海面晚霞空镜 | 33% | 29% | 好看,记不住 |
| 混合版 | 主歌氛围副歌叙事 | 36% | 19% | 折中,前五秒吃亏 |
翻车最狠的一条在叙事版主歌。我原本写"热气腾腾",结果蒸汽把人物半张脸糊掉了,出来的画面像蒸桑拿。改法是把热气收窄成"水槽上方少量蒸汽,不遮脸",一次过。这之后我多了个固定习惯:每条指令里动态元素最多留一个,多了模型就顾不过来。
重抽率也有差距。氛围版8条里3条面部崩了或运镜失控要重来,叙事版只重抽了1条。我猜是空镜里光线变化太复杂,模型反而不容易稳住。水声这类环境音我是在剪辑时另外垫的,参考了给视频配环境声的音效提示词写法,比指望模型顺便生成声音靠谱得多。
直接能抄的指令模板
句式:"第X段(歌词起止)加场景加人物动作加镜头运动加光线"。按这个顺序填空,换歌只改场景词就能复用。
给两条我用过的原文。主歌那条:"第1到8句,深夜老式厨房,女生背对镜头在水槽边洗碗,热气往上飘,镜头从她搭在水槽边的手缓推到窗外雨夜,暖黄台灯,画面稳定无转场。"副歌那条:"第9到16句,清晨小站站台,同一位女生穿米色风衣拖着行李箱走向长椅,中途回头,镜头跟随半圈后定格,冷白晨光,景深收窄。"
注意两条里人物是锁死的:同一位女生、米色风衣。跨片段不锁服装和发型,出来就是两个人。镜头运动这类词我没自创,直接照文生视频提示词里镜头、动作、时长三个关键项的搭配来,缓推、跟随、定格这几个词的出片成功率最高。
最常见的三个坑顺带列一下:一条指令塞整首歌,AI必乱;写"高级感""电影感"这类没有画面的词,等于没写;间奏段忘了给画面,AI会自己编一个唱KTV的镜头出来。挺离谱的,但它真干得出来。
回头看,唱歌视频提示词这件事,核心就是替AI把画面先想好,一段一句,宁细勿空。叙事版赢过氛围版这件事也提醒我,观众要的不是壁纸,是故事。你手边要是有首翻唱还没画面,不妨先把歌词拆成八段试试。
常见问题
一段唱歌视频提示词最多管多长的画面?
建议5到8秒。超过10秒,人物容易走样、运镜失控,我实测超过8秒的片段重抽率直接翻倍。宁可多切几段再剪。
不会剪辑,AI生成的片段能直接发布吗?
能发,但很难看。至少要做三件事:片段拼接、歌词字幕对齐、环境音垫底。剪映这类工具半小时能上手,别省这一步。
叙事版画面会不会把翻唱显得太土?
土不土取决于美术词,不取决于叙事结构。把"老式厨房"换成"玻璃幕墙公寓",把"米色风衣"换成"黑色大衣",格调立刻不一样,故事逻辑一点没变。
AI生成的人脸太像某位歌手怎么办?
立刻换掉。别在提示词里写真人歌手的名字或长相特征去仿脸,涉及冒用他人形象,既可能侵权也会被平台判违规。人物用虚构描述就够了,观众在意的是故事和歌声,不是那张脸像谁。