AI文献综述分段指令:检索、归类到评述的写法
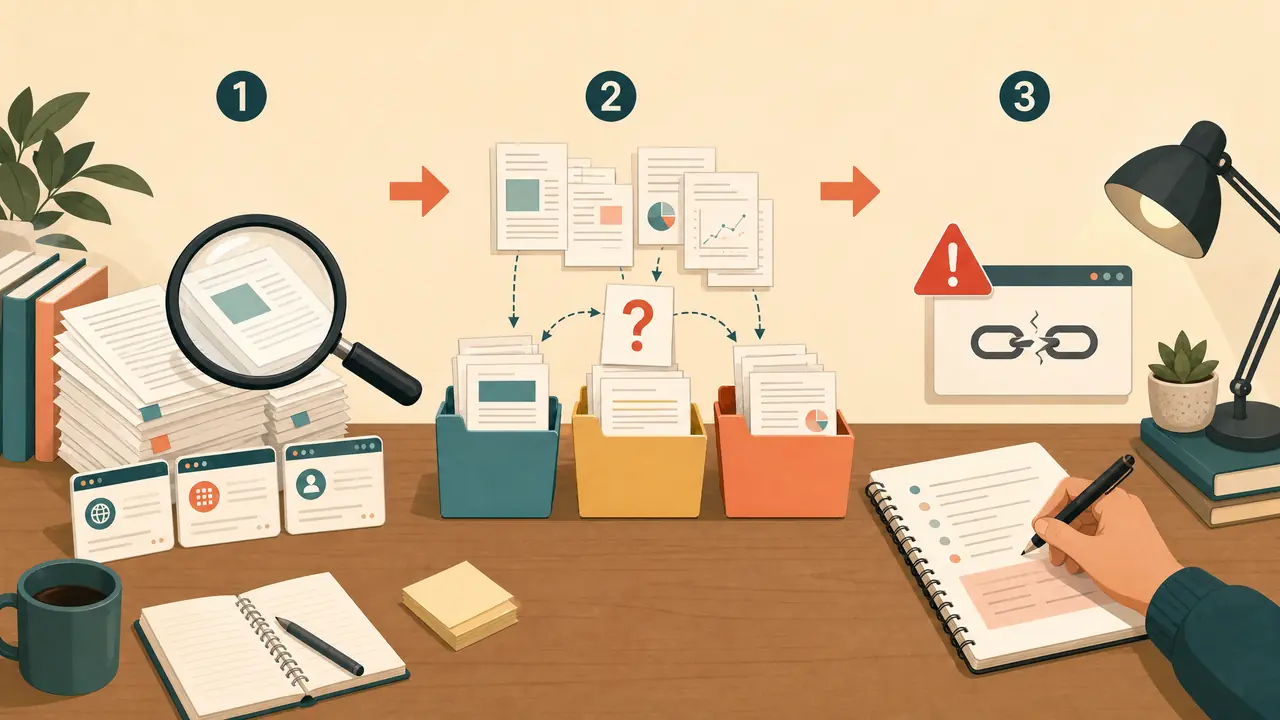
把检索、归类、评述拆成三段分别下指令,是AI辅助文献综述唯一稳妥的用法。二十篇文献实测下来,AI归类错了四篇,编造文献更是家常便饭——凡引用,必回原文核对。
AI文献综述分段指令的核心思路是拆:把检索、归类、评述拆成三段,每段一条指令,只让AI干一件小事。上个月我帮一位读研的朋友做「短视频使用与青少年睡眠质量」的初筛,手头二十篇文献。第一次偷懒,二十篇PDF整包丢给AI让它出综述,稿子读着挺顺,一查引用,二十条里六条的DOI在官网根本查不到,还有三篇作者真实、观点却被安错了人。整篇作废,返工四小时。
那次之后我把流程拆开重跑。结论放在最前面:AI不是不能碰综述,是不能一次性碰综述。任务颗粒度越小,它的错误越容易被你当场抓住。
AI文献综述分段指令为什么必须拆三段
AI的可靠度取决于任务颗粒度。任务越小、越可核对,它出错越容易被你抓住;一次性让它出整篇综述,错误会被流畅的行文盖住。检索段验证检索词,归类段核对类别,评述段逐句对原文——每一步都能用「是或不是」来判断,你才有底气往下走。混在一起跑,检索的错会污染归类,归类的错会污染评述,等你发现时已经分不清哪里开始烂的。
拆三段还有个隐性好处:每段之间留了人工介入点。我的节奏是检索段跑完花二十分钟定检索式,归类段跑完逐篇过一遍类别,评述段开始前先把二十篇各写一句自己的结论。AI负责粗加工,判断永远留在我这边。
检索段:只许出词,不许出文献
检索段只让AI产出检索词、数据库和布尔组合,明确禁止它列任何具体文献,它自己列的文献清单编造比例高得离谱。指令我是这么写的:「主题是短视频使用与青少年睡眠质量。你只负责帮我扩检索式:给出中英文数据库各自的检索词组合、同义词替换和布尔式,再列出你建议的筛选标准。禁止列出任何具体文献、作者、年份或DOI。」
同一个AI,两种指令,结果差出一个量级。让它列文献,二十条里六条查无此文;只让它出检索词,十四组词里十二组直接能用,剩下两组太宽,一筛八百多条,加时间限定才收敛。
老实讲,编造文献这件事没有侥幸空间。AI给出的每一条引用,DOI要去官网查证,标题要去数据库搜一遍,缺一个动作都可能把幻觉写进正式稿。那六条假文献里,有一条连期刊名都是拼接的,前半是真实刊名,后半挂了另一个刊的卷号,肉眼几乎看不出破绽。
顺带一提,当晚我顺嘴让它推荐几篇该领域的必读经典,它推得头头是道,五篇里两篇的书名根本不存在。跑题归跑题,这事反过来证明了一点:它嘴上的自信和内容的真伪,完全是两回事。
归类段实测:二十篇错四篇,错法有规律
二十篇实测里AI归对了十六篇,错四篇,全是跨类综述和客观测量研究。归类指令必须加「允许跨类」和「摘抄原文作依据」两条。不然它宁可硬塞也不留白。我的分类框架是三类:睡眠时长的测量方式、睡前的使用行为、干预实验。指令里固定写:「一篇可以同时属于两类,必须标注;每篇归类后摘抄摘要里不超过十五字的原文短语作依据;不确定就标存疑,不许硬塞。」这种让AI分情况、留出口的写法,和我整理过的让AI分情况讨论的指令是同一套思路。
翻车的场景我记得很清楚。上周四晚上十一点,我在书桌前过第七篇到第十一篇,AI把第十一篇归进「睡前使用行为」,理由是摘要里出现了bedtime use。我顺手翻原文的方法节——人家用的是腕式体动计,测的是客观睡眠时长,跟行为分组完全不搭。没辙,打回去重跑。
四篇错号的分布如下表,我顺手给每类错误标了个主观的危险分。
| 错法 | 篇数 | 原因 | 危险程度 |
|---|---|---|---|
| 跨主题的综述被硬塞进单一类 | 2 | 它默认每篇必有一个归属 | 中,类别统计会虚高 |
| 客观测量研究归进主观量表组 | 2 | 只认摘要措辞,不看方法 | 高,直接动摇综述立论 |
加上边界条件指令重跑之后,错误从四篇降到一篇。剩下那篇用了混合方法,横跨两类,AI标注了存疑——这个判断是对的。归纳一下必须人工核的三样:跨类文献的归属、摘要与方法是否一致、它给出的「原文依据」是否真在原文里。
评述段:AI排布观点,不发明观点
AI能做的只是把你给的观点排成段落,不能替你得出观点。评述段指令要逐句标注观点出处,核对时每句回原文确认。直接让它写评述,产出一水儿的「研究表明」「有学者指出」,没有判断,还有一处把王某2021年的结论安到了李某2022年头上。后来我改了流程:先自己给二十篇各写一句话结论,编号之后交给AI。
指令改成:「以下二十条是各文献的一句话结论,已编号。按三类组织段落,每段先列共识再列分歧,凡涉及具体结论必须引用编号,不得新增编号之外的观点,不得改动限定词。」这样跑出来的稿子结构清楚多了,但仍有两处把「部分研究显示」悄悄改成了「多数研究显示」。限定词被放大,这是它最隐蔽的错法。核对时我逐句对着编号回原文,两处都抓了回来。
我得承认,评述段的人工量没省多少。二十句结论我自己写,用了一个半小时;AI排布加我核对,四十分钟。省的是组织结构的时间,省不掉的是判断。学术这件事的底线没变:AI辅助整理,不代写观点,最终稿里每句话你得能对原文负责。
二十篇跑完,总耗时四个多小时,其中核对占了两小时半。AI文献综述分段指令的价值从来不是替你写综述,而是把每一步的错误摊在你眼前,让你在稿子烂掉之前就能抓住它。检索段要词不要文献,归类段留跨类的出口,评述段只排布观点不发明观点——三条记住了,剩下的功夫还是你自己的。
常见问题
二十篇文献是逐篇喂还是分批喂?
分批。每批五篇,贴标题加摘要就够,整篇PDF塞进去容易被截断,截断处的归类最不可靠。让AI用表格输出归类结果,编号加类别加依据短语,肉眼比对起来最快。
AI编造的参考文献怎么快速识别?
三个信号:DOI在官网查不到、作者在数据库里搜不到该领域的其他发文、年份与期刊的卷期对不上。中一条就该起疑,正式引用前逐条回原文,别信AI报的「出处」。我那六条假文献,四条靠DOI查证直接暴露。
用AI整理文献综述算学术不端吗?
各校口径不一,通用底线倒是一致:AI不署名、不代写观点、引用必须真实且核对过。提交或投稿前,按目标学校或期刊的AI使用政策如实声明,具体条文以你所在机构的现行规定为准。
归类指令里的类别数量怎么定?
先自己粗读一遍摘要,列三到五类。类别太少,AI偷懒硬塞;太多,它来回摇摆。每个类别的定义要写成可判定的条件,比如「测量工具为自评量表」,而不是「与睡眠相关」这种。
分段指令对英文文献一样管用吗?
管用。指令换成英文,我实测归类准确率还略高一点,二十篇里错三篇。编造文献的问题一样存在,核对环节一步不能省。
延伸阅读
- 翻译时态提示词怎么用?让AI按指定时态输出的指令——评述段里「逐句锁定输出格式」是同一思路的延伸。