GLM 5.3提示词怎么写?从5.2迁移的指令调整实测
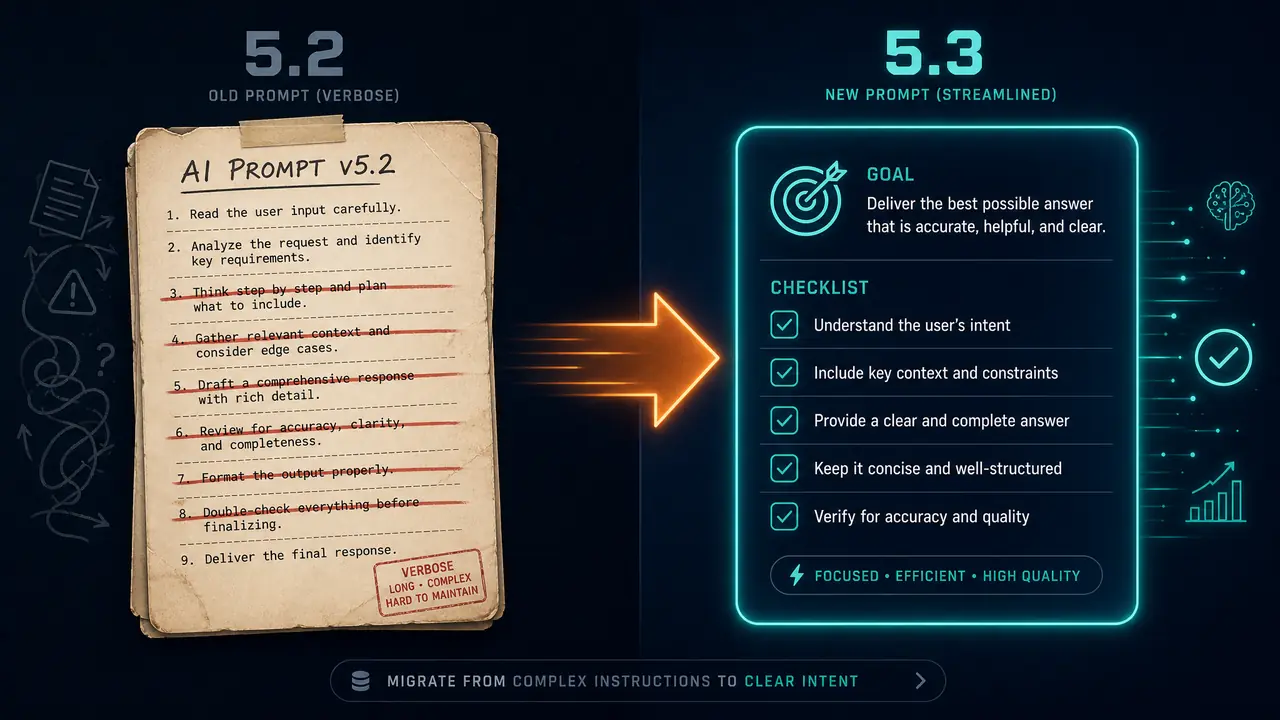
把5.2的老指令原样搬进5.3,是我九月踩过最冤的一个坑。GLM 5.3思考强制开启、默认max档,一批旧写法要么直接报错,要么被模型自作主张改写。这篇用三个翻车实例,给你能照抄的迁移改法。
GLM 5.3提示词怎么写?先说结论:别照搬5.2的老指令。这次升级没有换基座,官方文档写得清楚,5.3和5.2用的是同一个基础模型,提升全部来自后训练。能力涨了,脾气也变了——思考功能永远开着,不再支持关闭。我九月二号拿到Coding Plan额度,当天晚上就把仓库里三套跑了半年的老指令搬过去重跑了一遍。两套当场翻车。下面按翻车顺序逐个讲。
GLM 5.3提示词怎么写:先弄清它跟5.2差在哪
5.3和5.2共用同一基座,差距全在后训练。对写提示词影响最大的三点:思考不可关、默认max档、长任务更自主。先补几个硬数字。官方口径:编程基准比5.2提升50%,Terminal-Bench 3.0从4.6涨到28.3,DeepSWE v1.1从46.2涨到66.9;上下文1M,最大输出128K,仅支持文本。这些都出自智谱官方的GLM-5.3模型文档,不是我编的。
对提示词写手,真正要紧的是三件事。第一,思考开关没了:官方迁移注意事项明确写着,原来把thinking.type设成disabled的应用,必须改成enabled并把reasoning_effort设为low,否则请求直接失败。第二,思考分low、high、max三档,默认max——你什么参数都不传,它也会往深了想。第三,token效率变了:官方数据里每个任务平均输出约7.5万token,5.2约9.6万。看着省了,但那是模型自己省,不代表你的指令写得省。
说实话,看到「同一基座、纯后训练」那行字时我心里还咯噔了一下。同一基座意味着提示词理论上兼容,可后训练恰恰是最容易改变指令敏感度的环节。岔开一句,那晚我一度怀疑是自己额度没充上,折腾了十来分钟才发现是thinking参数的问题,白冤枉自己一场。后来三套指令翻了两套的结果证明,担心不算多余。
翻车第一例:让它「别思考直接答」,它回我一个报错
5.3不能关闭思考。指令里只要出现「关闭思考模式」「直接回答别想」这类写法,要么请求报错,要么被完全无视。我的老指令里有一道数据核对题,为了抢速度,5.2时代我习惯在开头写一句「关闭深度思考,拿到问题直接给答案」。九月二号晚上十一点多,这条指令在5.3上第一次跑,API直接甩回来一个错误提示。当时还愣了几秒。
改法没什么花活:把「关闭思考」这类话从提示词里删干净,想控速度就去参数层把reasoning_effort设成low,别在正文里跟模型较劲。我试了下同一道题,5.2关思考8秒出结果,十次对七次;5.3用low档19秒,十次对九次。多花11秒换两个正确,这笔账怎么算都划算。
老实讲,一开始我还不死心,在提示词里加了句「请你跳过思考环节」试试。没用。模型不会跟你吵,它就是照着新设定走。翻车翻得明明白白。
翻车第二例:七步流程指令,被它自作主张压成三步
5.3更适合目标导向的写法。把「第一步做什么」换成「做到什么算好」,任务完成度反而上去了。第二套翻车的是给客户做周报数据清洗的老指令,五个步骤写得密密麻麻,从去重讲到列名规范。九月三号夜里,我盯着屏幕看它把我写的七步压成三步,还擅自合并了两列,愣了足足半分钟说不出话。
5.2那会儿,细流程指令是主流写法,你写得越细它越听话。5.3默认开max思考,接到任务会先自己规划一遍,你那七步在它眼里有三步属于冗余,直接砍掉,中间过程也不给你看了。这时候继续加细,只会更拧巴。
我的改法是把「怎么做」整段删掉,换成「做到什么算好」:输入是什么、输出必须长什么样、验收清单列三条,过程让它自己定。改完连跑十次,十次格式全对。验收条件里涉及分情况的措辞,可以参考之前写的让AI分情况讨论的临界条件指令,思路是通的:把边界写清楚,比把路径写死更有用。
翻车第三例:格式约束写结尾,长任务跑到一半开始飘
格式和字数约束要放在提示词前半段,并附一个输出骨架样例。写在结尾,长任务里会先被稀释。第三套翻车的指令,5.2的老习惯是把输出格式要求压轴放在提示词最后,5.2上一向好使。搬到5.3跑长任务,前三分之一的输出规规矩矩,跑到后半段标题层级开始乱,该用表格的地方给成了段落。确实离谱。
原因不难猜:5.3输出长、思考深,结尾的约束走到几千token之后就淡了。我把格式要求挪到提示词开头,再附一个十来行的输出骨架,问题消失,连跑五次没再飘过。约束这种东西,越早说越管用。
三例对照一下。
| 老写法(5.2好用) | 5.3翻车现场 | 我的改法 | 主观评价 |
|---|---|---|---|
| 写「关闭思考,直接答」 | 请求直接报错 | 删掉,参数层用reasoning_effort=low | 最省事的一改 |
| 七步细流程逐步指令 | 被压成三步还跳步骤 | 换成目标加验收清单 | 改完效果反超5.2 |
| 格式要求放结尾压轴 | 长任务后半段开始飘 | 约束前置加输出骨架 | 最容易忽略的一处 |
回到开头的问题:GLM 5.3提示词怎么写?答案不是另起炉灶,而是做减法和换位置——删掉控制思考的话,把管流程改成管验收,把约束挪到前面。三套指令我前后改了不到半小时,费的是重新摸清它脾气的那点心思。老指令不必重写,得先让它们认认新主人。
常见问题
GLM 5.3的temperature和max_tokens官方推荐多少?
官方调用示例里temperature设1.0,max_tokens设65536。思考档位默认max,官方建议编程等复杂任务保持max;想省思考开销再降到low或high,别上来就改默认值。
不写代码,日常问答也要改提示词吗?
要留意。默认max思考下,随口一问它也会先想一轮,响应比5.2慢一些。把「回答控制在多少字」这类要求写在提示词开头,比旧习惯里想到哪写到哪更稳。
GLM-5.3能看图吗?
不能。官方文档标注仅支持文本模态,上下文1M,最大输出128K。要处理图片得换多模态模型,别在指令里白费笔墨描述图片。
从5.2迁移API调用要动哪些参数?
两条。原来thinking.type设了disabled的,必须改成enabled并把reasoning_effort设为low,不然请求失败;订阅过GLM Coding Plan的用户(含已过期),暂时只能走OpenAI Chat Completion协议调用。